CTC 联结时序分类
免对齐的端到端语音识别损失
一、引言
传统语音识别系统需要"帧级对齐"——即预先知道每一帧声学特征对应哪一个音素标签,才能训练声学模型。这种对齐标注极其昂贵,通常需要借助隐马尔可夫模型(HMM)做强制对齐(Forced Alignment)来获得。联结时序分类(Connectionist Temporal Classification, CTC)的提出,从根本上改变了这一局面:它允许模型直接从输入声学序列映射到输出标签序列,无需任何帧级对齐,从而让端到端语音识别成为可能。
CTC 由 Alex Graves 等人于 2006 年提出,最早用于手写识别,随后成为语音识别领域最具影响力的技术之一。其核心思想是用一个"空白符"(blank)来处理重复与可变长度问题,并对所有可能的对齐路径求和,从而定义出无需对齐的损失函数。
二、公式表达
给定输入声学序列 X(长度 T)与目标标签序列 Y(长度 U ≤ T),CTC 的目标是最大化所有能"折叠"成 Y 的对齐路径的总概率。其负对数似然损失定义为:
ℒ_CTC = -ln Σ_π ∈ ℬ^-1(Y)\ Π_t=1^T p_π_t(t)
各符号含义如下表所示。
符号 | 含义说明 |
|---|---|
T | 输入声学序列的时间帧总数 |
π | 一条帧级对齐路径,π = (π₁, π₂, …, π_T),每帧输出一个标签或空白符 |
π_t | 对齐路径在第 t 帧输出的符号 |
p_{π_t}(t) | 第 t 帧输出符号 π_t 的概率(由网络 softmax 层给出) |
B | 折叠映射:去除连续重复标签、再去除空白符 |
B⁻¹(Y) | 所有能折叠成目标标签序列 Y 的对齐路径的集合 |
L_CTC | CTC 损失,即负对数似然 |
三、公式的推导与原理解析
(一)"折叠"映射 B 的定义
CTC 引入一个特殊符号 blank(记作 ε),网络的输出层在每个时刻 t 输出一个覆盖"标签集合 + {ε}"的概率分布。一条对齐路径 π 经过映射 B 折叠为标签序列的规则是:将连续重复的相同标签合并为一个,然后删除所有 blank。例如,对齐路径 "a a ε b b ε a" 折叠后得到 "a b a",而 "a ε a ε b" 折叠后得到 "a a b"。
这种设计巧妙地解决了两个问题:其一,同一标签连续出现(如"哈"字连续)靠 blank 或标签间的切换来区分;其二,输入长度 T 通常远大于输出长度 U,多余的帧通过输出 blank 来"消耗"。
(二)前向-后向算法的可训练性
直接枚举所有对齐路径 B⁻¹(Y) 是指数级不可行的。CTC 的关键贡献在于,可以用动态规划中的前向-后向算法(Forward-Backward Algorithm),在 O(T·U) 的时间复杂度内高效计算上述求和及其梯度。前向变量 α(t, u) 表示到第 t 帧为止已生成标签序列前 u 个字符的所有路径概率和,后向变量 β(t, u) 则对称地处理剩余部分。两者相乘并对所有时刻求和,即可得到全部对齐路径的总概率。
(三)条件独立假设的代价
CTC 隐含一个强假设:不同时刻的输出彼此条件独立。这意味着 CTC 本身不建模标签之间的语言依赖,因此在语言建模能力上弱于注意力模型或 RNN-T。实践中,往往需要配合外部语言模型或采用 CTC/Attention 混合架构来弥补这一不足。
四、实际应用场景
(一)端到端语音识别的主流组件
以 Conformer、Wav2Vec 2.0、Whisper 为代表的现代端到端 ASR 模型,其训练损失大量采用 CTC。它让"音频特征 → 文字"的端到端训练成为可能,省去了传统系统的词典、音素集、HMM 状态等复杂构件。
(二)流式识别的低延迟特性
CTC 天然支持逐帧输出,配合"峰值处理"或"帧同步解码",可以实现极低的输出延迟,非常适合实时语音转写、会议记录、直播字幕等对时效要求高的场景。
(三)多任务与多语言扩展
CTC 与注意力损失的联合训练(Hybrid CTC/Attention)在 ESPnet 等工具中被广泛采用,兼顾了 CTC 的单调对齐优势与注意力模型的建模能力。此外,CTC 也常用于多语言、零资源语音识别的统一建模。
五、示例说明
设目标标签序列 Y = "cat"(字母 c-a-t),输入共有 4 帧。网络在每帧输出 c/a/t/ε 四个符号的概率。一条对齐路径 π = "c a ε t" 折叠后恰为 "cat",其概率为:
p_c(1) · p_a(2) · p_ε(3) · p_t(4)
CTC 损失会累加所有此类合法路径(如 "c c a t"、"ε c a t"、"c a t t" 等折叠后仍为 "cat" 的路径)的总概率。训练目标是让这些合法路径的总概率最大化,从而推动网络学会把声学帧"汇聚"成正确的字符序列,而不必关心具体哪一帧对应哪个字符。
六、小结
CTC 通过空白符与折叠映射的巧妙设计,定义了无需帧级对齐的序列损失,配合前向-后向算法实现高效训练,是端到端语音识别的基石之一。理解 CTC,就理解了现代语音识别"摆脱对齐束缚"这一关键转折。
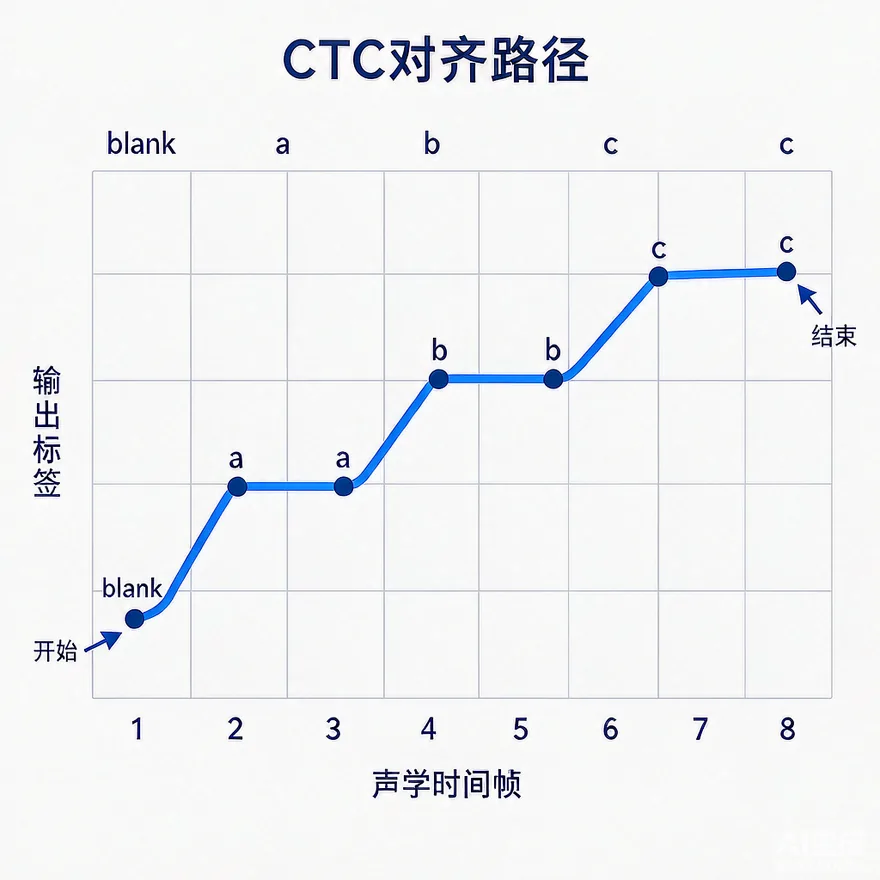
图 1 CTC 对齐路径网格示意:空白符与标签沿时间轴单调推进