贝叶斯语音识别准则
从声波到文字的统计最优解码
一、引言
语音识别(Automatic Speech Recognition, ASR)的核心任务,是把一段连续的声学信号 O(观测序列,例如一串 MFCC 或 FBank 特征向量)转写为最可能的文字序列 W。这个看似简单的"听写"问题,其数学根基却可以追溯到两百多年前托马斯·贝叶斯提出的一条朴素而深刻的定理。现代统计语音识别系统——从早期的隐马尔可夫模型(HMM)混合系统,到如今主流的深度神经网络声学模型——无论内部结构如何演进,其解码的顶层准则始终如一:在给定观测声学特征的前提下,寻找后验概率最大的词序列。
本文将系统阐述这一准则的数学表达、符号体系、推导逻辑,并结合真实语音系统的解码过程,说明它如何贯穿从声学建模到语言建模的每一个环节。
二、公式表达
语音识别的基本问题是:给定观测特征序列 O,求最可能的词序列 W*。依据贝叶斯定理,可以得到如下核心公式:
W^* = argmax_W\ P(W | O) = argmax_W\ (P(O | W) P(W))/(P(O)) ∝ argmax_W\ P(O | W)_声学模型 · P(W)_语言模型
其中,各符号的含义如下表所示。
符号 | 含义说明 |
|---|---|
O | 观测声学特征序列,通常为逐帧提取的 MFCC / FBank / 滤波器组特征向量序列 |
W | 候选词序列(识别假设),如"今天天气很好" |
W* | 使后验概率最大的最优识别结果 |
P(O | W) | 声学模型给出的似然度:词序列 W 产生观测 O 的概率 |
P(W) | 语言模型给出的先验概率:词序列 W 在语言中自然出现的概率 |
P(W | O) | 后验概率:给定观测 O 时 W 为正确结果的概率 |
P(O) | 观测的先验概率,与 W 无关,在最大化时可视作常数 |
三、公式的推导与原理解析
(一)从贝叶斯定理出发
贝叶斯定理给出了后验概率与似然、先验之间的关系:
P(W | O) = P(O | W) · P(W) / P(O)
在语音识别的解码阶段,我们面对的是固定的观测 O,因此分母 P(O) 对所有候选词序列 W 都是同一个常数,不参与比较。于是最大化后验概率等价于最大化分子,即声学模型得分与语言模型得分的乘积。这正是上式中"正比于"符号的来源。
(二)声学模型与语言模型的角色分工
上述公式天然地把语音识别问题拆解为两个可独立优化的子问题。
声学模型 P(O | W) 回答的问题是:如果一个人说了一段话 W,观测到特征序列 O 的可能性有多大。传统上,它由 HMM 描述语音单元(音素、三音子)的时序转移,由高斯混合模型(GMM)或深度神经网络(DNN)描述每个状态下特征向量的发射概率。随着深度学习的发展,DNN-HMM 混合架构乃至端到端模型,都是在用更强大的模型去逼近这一似然。
语言模型 P(W) 回答的则是:这段文字本身是否符合某种语言的习惯。例如,同音词"山西"与"陕西",仅凭声学层面往往难以区分,但语言模型可以依据上下文给出更合理的取舍。统计 n-gram 语言模型、递归神经网络语言模型(RNNLM),乃至基于 Transformer 的大规模预训练语言模型,都是对 P(W) 的建模。
(三)对数域的计算与"三音子"展开
实际工程中,概率相乘会带来数值下溢,因此解码通常在对数域进行,把乘积化为求和。同时,词序列 W 需要展开为更细粒度的单元序列(音素或三音子),引入隐状态序列 S,于是目标函数进一步写作:
W* = argmax_W max_S { log P(O | S, W) + log P(S | W) + λ · log P(W) }
其中 λ 为语言模型权重,用于调节声学得分与语言得分的相对贡献;这种形式由搜索算法(如 Viterbi 解码)在巨大的搜索空间中高效求解。图中展示了这一完整链路。
四、实际应用场景
(一)传统 HMM-GMM/DNN-HMM 混合系统
这是贝叶斯准则最经典、最成熟的落地形态。以 HTK、Kaldi 等工具链为代表,声学模型由 HMM 拓扑 + GMM/DNN 发射概率构成,语言模型用 n-gram,解码用加权有限状态转换器(WFST)统一构图,最终通过 Viterbi 搜索求取最优路径。这一体系支撑了数十年间绝大多数商用识别系统。
(二)端到端系统的"隐性"延续
表面上看,CTC、RNN-T、Attention 等端到端模型直接输出文本,似乎不再显式使用上述贝叶斯框架。但实际上,端到端模型内部通过外部语言模型融合(如浅融合 Shallow Fusion)时,依然会引入一个独立的语言模型分数,其本质仍是"声学得分 + 语言得分"的加权组合,是贝叶斯准则在端到端范式下的延续。
(三)语音智能体中的实时识别
在 SynaVoice 一类的语音智能体中,流式 ASR 引擎正是以该准则为解码核心。当用户话音到达,系统逐帧提取特征、动态更新搜索假设,并结合语言模型持续输出最可能的文字,为后续的意图理解与对话管理提供可靠的文字输入。
五、示例说明
假设一段中文语音 O,候选词序列有两个:W1 = "我去银行",W2 = "我去很行"。
声学模型得分:由于"银行"与"很行"读音相近,P(O | W1) 与 P(O | W2) 相差不大;
语言模型得分:在常见语料中,"去银行"远比"去很行"自然,因此 P(W1) 远大于 P(W2);
综合决策:P(O | W1)·P(W1) > P(O | W2)·P(W2),系统最终输出"我去银行"。
这个例子清晰地展示了语言模型如何通过先验知识"纠偏"声学层面的歧义,正是贝叶斯准则"声学 × 语言"联合决策思想的生动体现。
六、小结
贝叶斯语音识别准则以一条简洁的公式,统一了语音识别中声学建模与语言建模两大支柱。它不仅是理解经典混合系统的钥匙,也为端到端模型的"声学-语言"融合提供了理论注解。掌握这一准则,就掌握了从统计视角理解语音识别的核心支点。
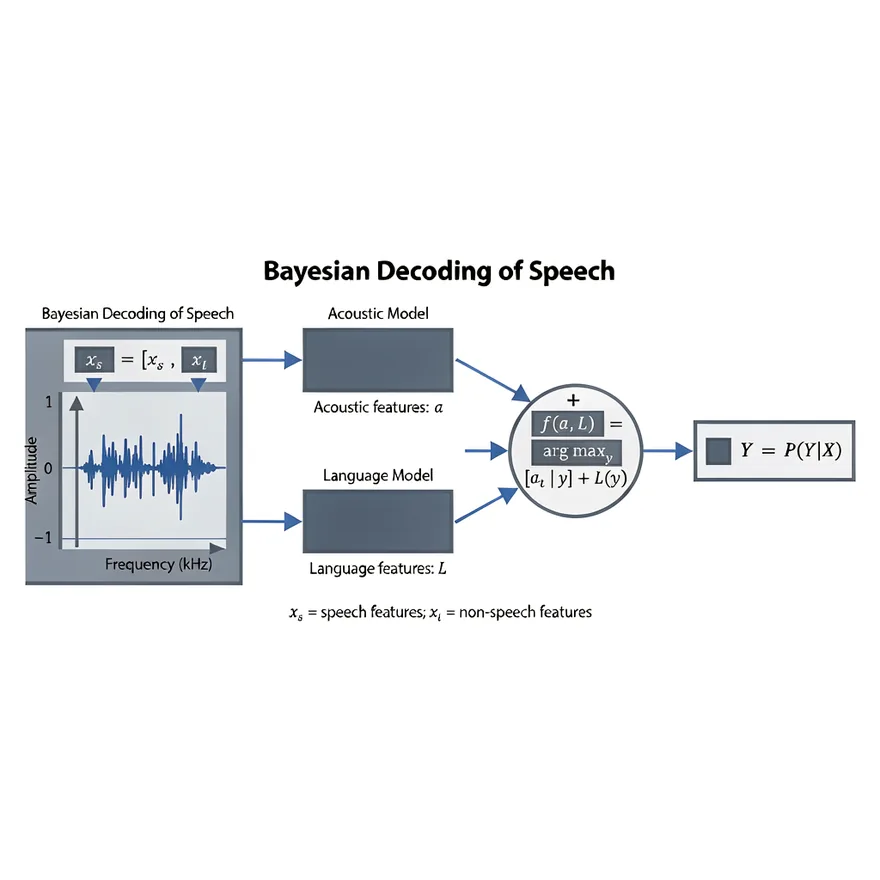
图 1 贝叶斯语音识别解码流程示意:声学模型与语言模型联合决策