RNN-T 循环神经网络转导器
面向流式的增量语音识别
一、引言
当语音识别从"整句转写"走向"边说边出字"的实时交互时,一个关键需求浮现出来:模型必须支持增量解码——在语音尚未结束时,就持续输出已经可以确定的部分文字。联结时序分类(CTC)虽然摆脱了对齐,但其逐帧独立输出的特性并不天然适合建模"已生成文本对后续预测的约束"。RNN-T(RNN Transducer,循环神经网络转导器)正是为解决这一问题而生,它结合了声学编码与文本自回归解码,成为流式语音识别的主流范式。
RNN-T 由 Alex Graves 于 2012 年提出,随着近年大模型的兴起,它重新成为工业界流式 ASR(如 Google 的语音搜索、语音助手)的核心选择。其最大魅力在于:既能像 CTC 一样天然处理任意长度的输入输出对齐,又能像语言模型一样建模输出文本之间的依赖关系。
二、公式表达
RNN-T 的目标同样是最大化给定输入声学序列 X 时输出标签序列 Y 的概率,其损失定义为对所有合法对齐路径 α 的概率求和后取负对数:
ℒ_RNN-T = -ln Σ_α ∈ 𝒜(X,Y)\ Π_i=1^T+U p(α_i | x_1^ t_i, y_1^ u_i-1)
各符号含义如下表所示。
符号 | 含义说明 |
|---|---|
X | 输入声学序列,X = x₁, x₂, …, x_T,共 T 帧 |
Y | 目标标签序列,Y = y₁, y₂, …, y_U,共 U 个标签 |
α | 一条合法对齐路径,由标签符号与空白符(blank)交织而成 |
α_i | 对齐路径在第 i 步输出的符号 |
A(X, Y) | 所有合法对齐路径的集合 |
t_i | 输出第 i 步时已消费的输入帧数 |
u_i | 输出第 i 步时已生成的标签数 |
p(α_i | ·) | 联合网络(Joint Network)在当前条件下给出的输出分布 |
三、公式的推导与原理解析
(一)三大模块的协同
RNN-T 由三个网络构成:
编码器(Encoder):处理声学输入 X,得到逐帧的高层声学表示 h_t;
预测网络(Prediction Network):处理已生成的文本前缀 y_1…y_{u-1},得到语言侧表示 g_u,它本质上扮演了一个内建语言模型的角色;
联合网络(Joint Network):将 h_t 与 g_u 融合,输出一个覆盖"标签集合 + 空白符"的分布,即上式中的 p(α_i | ·)。
这一架构让模型在生成每个输出符号时,既参考"听到了什么"(声学编码),又参考"已经说了什么"(文本前缀),从而兼具对齐能力与语言建模能力。
(二)对齐路径与"网格"结构
RNN-T 的对齐路径可以直观地画在一个 (T+1)×(U+1) 的网格上:横轴表示已消费的声学帧数 t,纵轴表示已生成的标签数 u。路径每一步要么"向右"(输出一个 blank,即多听一帧但不输出标签),要么"向上"(输出一个真实标签)。从 (0,0) 到 (T,U) 的所有单调路径,构成了 A(X, Y)。
(三)前向-后向算法的复用
与 CTC 类似,RNN-T 的求和同样指数级路径,无法直接枚举。借助前向-后向算法,可以在 O(T·U) 的时间内高效计算损失与梯度。此外,RNN-T 还支持一种高效的"贪婪 + 局部对齐限制"的近似解码(如限制 blank 输出的数量、束搜索等),以满足流式场景的低延迟要求。
四、实际应用场景
(一)流式语音识别
RNN-T 天然支持逐帧增量输出,是流式 ASR 的首选架构。Google 的语音输入、语音助手,以及众多实时字幕、会议转写系统,都基于 RNN-T 或其变体(如利用"快速发出"技术减少 blank 输出以降低延迟)。
(二)语音智能体的实时交互
在 SynaVoice 这类对话式语音智能体中,用户话音实时到达,RNN-T 引擎边听边出字,将文字流即时送入下游的自然语言理解与对话管理模块,是实现"边说边响应"低延迟体验的关键技术底座。
(三)多任务与统一建模
RNN-T 的预测网络可扩展为更大的语言模型(如与外部 LM 融合),也可用于多语言、热词(Biasing)等场景。近年来,RNN-T 与 Conformer 编码器结合(Conformer-Transducer),已成为流式 ASR 的工业标准组合。
五、示例说明
设目标标签序列 Y = "hi"(两个标签 h、i),输入有 3 帧声学。一条合法对齐路径可能是:
ε · ε · h · i
其含义为:先输出两个 blank(消费前两帧,尚未确定内容),随后输出标签 h,再输出标签 i。这条路径的概率为:
p_ε(1) · p_ε(2) · p_h(3, u=0) · p_i(3, u=1)
其中预测网络在输出 h 之前"看到"了空前缀,在输出 i 之前"看到"了前缀 "h"。可见,RNN-T 的每一次输出都依赖已生成的文本历史,这正是它区别于 CTC 的核心之处——它在解码时自带语言约束。
六、小结
RNN-T 通过"声学编码 + 预测网络 + 联合网络"的三段式结构,将 CTC 的免对齐优势与语言建模能力融为一体,是流式、增量语音识别的关键算法。理解 RNN-T 的网格对齐与前向-后向计算,是掌握现代实时语音识别系统的必经之路。
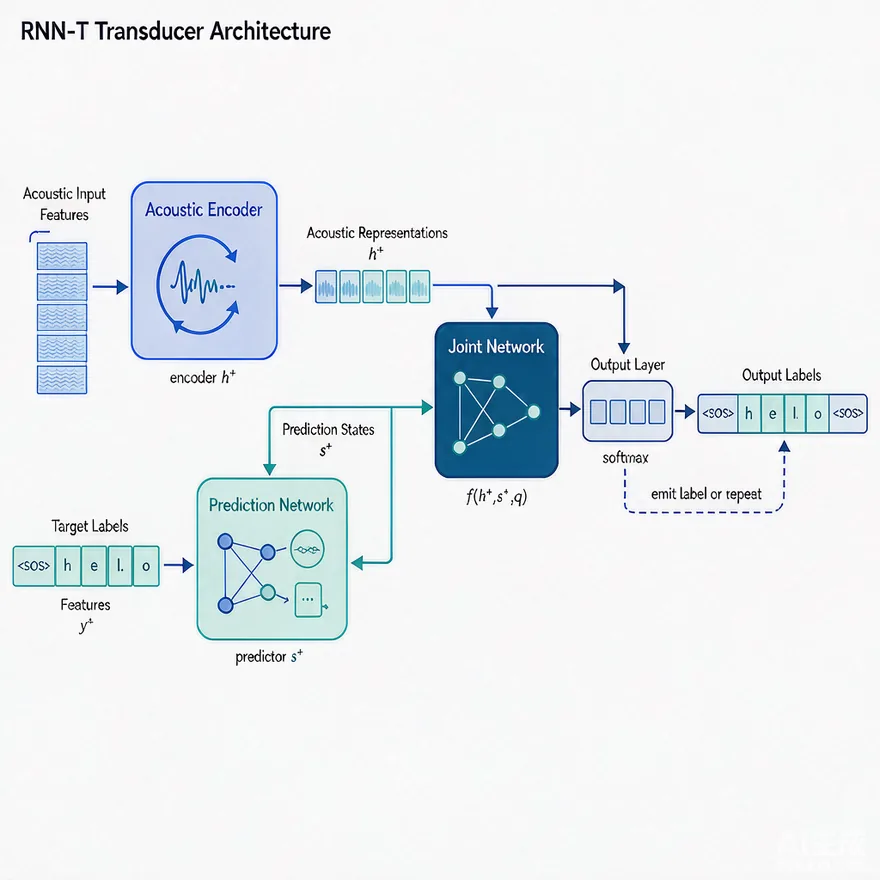
图 1 RNN-T 三大模块架构:编码器、预测网络与联合网络协同