HiFi-GAN 神经声码器
生成对抗网络与高保真波形重建
一、引言
在神经语音合成(TTS)的流水线中,声学模型负责把文本转换为声学特征(通常是 Mel 谱),而最后一步——把 Mel 谱还原为可听的高保真波形——则由神经声码器(Neural Vocoder)完成。这一步的质量直接决定了合成语音的音质,是 TTS 系统的"临门一脚"。
HiFi-GAN 是神经声码器领域最具代表性的工作之一,由 Kong 等人于 2020 年提出。它借鉴生成对抗网络(GAN)的思想,用多个判别器与生成器对抗训练,同时辅以特征匹配损失与 Mel 谱损失,实现了既能快速推理又能高保真重建的波形生成,成为众多开源 TTS 系统(如 VITS、FastSpeech 2 的后端)的默认声码器之一。
二、公式表达
HiFi-GAN 训练生成器 G 时,其总损失由对抗损失、特征匹配损失与 Mel 谱重建损失三部分加权构成:
ℒ_G = Σ_k [(D_k(x̂) - 1)^2] + λ_fm Σ_k (1)/(N_k)‖D_k(x) - D_k(x̂)‖_1 + λ_mel ‖φ(x) - φ(x̂)‖_1
各符号含义如下表所示。
符号 | 含义说明 |
|---|---|
x | 真实语音波形 |
ẋ | 生成器 G 由 Mel 谱合成的波形,ẋ = G(z),z 为输入 Mel 谱 |
D_k | 第 k 个判别器(可以是多个子判别器,覆盖不同周期/尺度) |
D_k(·) | 判别器对输入波形输出的判别分数(或中间层特征) |
φ(·) | Mel 谱提取算子,将波形转换为 Mel 谱 |
λ_fm | 特征匹配损失的权重系数 |
λ_mel | Mel 谱重建损失的权重系数 |
N_k | 第 k 个判别器某层特征的维度(归一化用) |
L_G | 生成器的总损失 |
三、公式的推导与原理解析
(一)对抗损失:让生成波形"以假乱真"
第一项是标准的 GAN 对抗损失。生成器 G 试图让判别器 D_k 把生成的波形 ẋ 判为真实(即 D_k(ẋ) 接近 1),从而最小化 (D_k(ẋ) - 1)²。这里采用最小二乘 GAN(LSGAN)形式,相比原始的交叉熵 GAN,训练更稳定、梯度更平滑。
(二)多判别器设计:捕捉不同尺度的周期结构
语音波形具有明显的周期性(基频、谐波结构)。HiFi-GAN 设计了多个判别器:多周期判别器(Multi-Period Discriminator, MPD) 将波形按不同周期长度重排成二维,分别捕捉不同周期的模式;多尺度判别器(Multi-Scale Discriminator, MSD) 则在多个下采样尺度上判别。多个判别器的对抗信号叠加,让生成器从多个视角学习逼真的波形结构。
(三)特征匹配损失:稳定训练、提升真实度
第二项是特征匹配损失(Feature Matching Loss)。它要求生成波形经过判别器中间层得到的特征,与真实波形的对应特征尽量接近(以 L1 距离度量)。这一项不通过判别器打分,而是直接对齐特征,能显著稳定 GAN 训练,并促使生成器学到更真实的中间表示。
(四)Mel 谱重建损失:保证内容正确
第三项是 Mel 谱重建损失。它将生成波形重新提取 Mel 谱 φ(ẋ),与真实波形的 Mel 谱 φ(x) 做 L1 距离。这一项是"内容保真"的关键——它确保生成的波形在听觉频域上忠实于输入的 Mel 谱条件,避免 GAN 训练"自由发挥"导致内容失真。
四、实际应用场景
(一)神经 TTS 的波形合成后端
HiFi-GAN 作为声码器,被 VITS、FastSpeech 2、Tacotron 2 等众多 TTS 系统采用,将声学模型预测的 Mel 谱实时转换为高保真语音,是端到端语音合成产业化的关键组件。
(二)语音智能体的个性化音色
在 SynaVoice 这类对话式语音智能体中,声码器的质量直接影响合成语音的自然度与音色表现。通过在不同说话人数据上训练或微调,HiFi-GAN 可支持多样化的音色,为智能体提供"拟人化"的语音输出。
(三)实时合成与低延迟推理
HiFi-GAN 采用全卷积结构,推理速度极快,能在 CPU 甚至移动端实时合成,满足流式 TTS、语音助手等对低延迟的严苛要求。
五、示例说明
设输入一段 Mel 谱,目标是对应的语音"早上好"。生成器 G 接收 Mel 谱,经过上采样与卷积层逐步扩大时间分辨率,输出波形 ẋ。训练时:
对抗损失促使 ẋ 在"听起来像真实人声"这一目标上逼近;
Mel 谱损失确保 ẋ 的内容确实是"早上好"三个字的发音;
特征匹配损失则让 ẋ 的中间特征与真实录音一致,进一步稳定训练。
三者协同,最终合成的波形既自然清晰,又忠实于输入文字内容。相比早期的 WaveNet 自回归声码器(逐采样生成、速度慢),HiFi-GAN 以并行生成实现了数百倍的速度提升,同时保持了高音质。
六、小结
HiFi-GAN 以"多判别器 GAN + 特征匹配 + Mel 谱重建"的巧妙组合,在速度与音质之间取得了优异平衡,是神经声码器的标杆。理解它的三项损失如何协同,就理解了现代语音合成"从频谱到波形"这最后一步的关键技术。
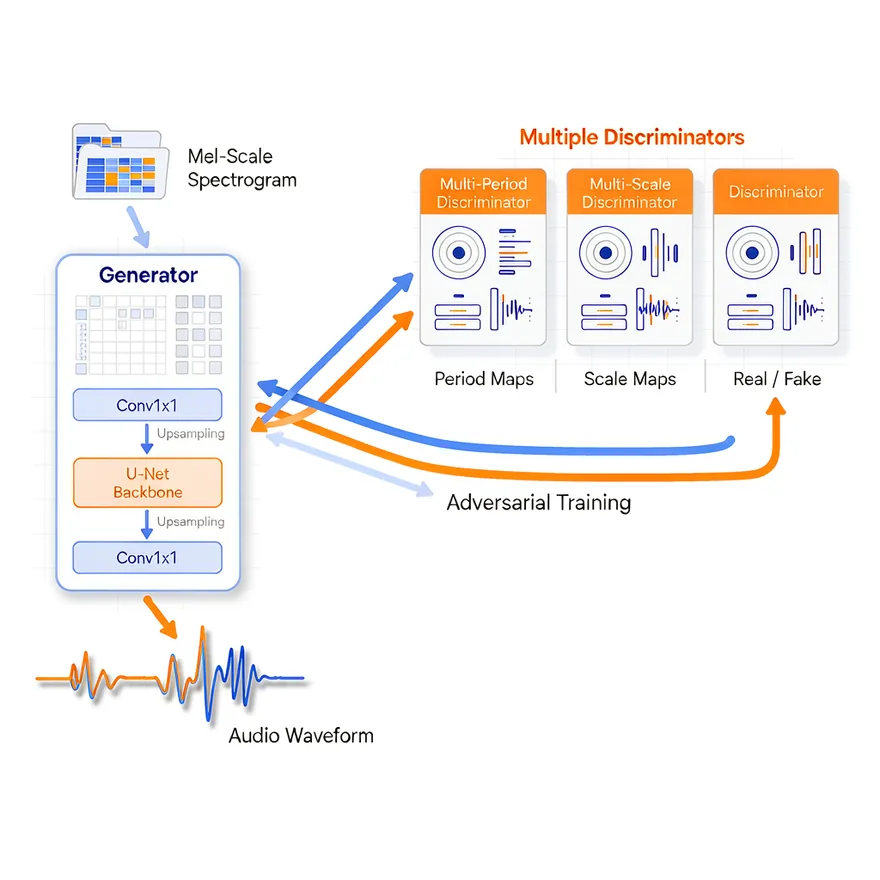
图 1 HiFi-GAN 对抗训练框架示意:生成器与多判别器对抗